标签: GLM-5.1 智谱 开源大模型 SWE-bench-Pro
云梦级4月8日云梦级消息,智谱今日正式发布新一代开源模型 GLM-5.1,官方称这是目前全球最强的开源模型。据官方标签介绍,其是唯一达到 8 小时级持续工作的开源模型,在最接近真实软件开发的 SWE-bench Pro 基准测试中,GLM-5.1 实现: 国产模型首次超越 Opus 4.6。
OpenRouter 显示,伴随此次发布,智谱 GLM 再度提价 10%。调价后,GLM-5.1GL 在 Coding 场景的缓存命中 Token 价格已接近 Anthropic 旗下 Claude Sonnet4.6 水平。这是国产M-大模型首次在核心场景实现与海外头部厂商的价格对齐。
官方详细介绍如下:
从 3 分钟的 Vibe Coding(氛围编程)到 35.0 分钟的 Agentic Engineering(智能体工程),再到本次我们带来的 8 小时 Long-Horizon Task(长程1 任务),GLM-5.1 再次取得突破。
GLM-5.1 是我们迄今最智能的旗舰模型,也是目前全球最强的开源模型。GLM-5智谱.1 大大提高了代码能力,在完成长程任务方面提升尤为显著。和此前分钟级交互的模型不同,它能够在一次任务中独立、持续工作 开超过 8 小时,期间自主规划、执行、自我进化,最终交付完整的工程级成果。
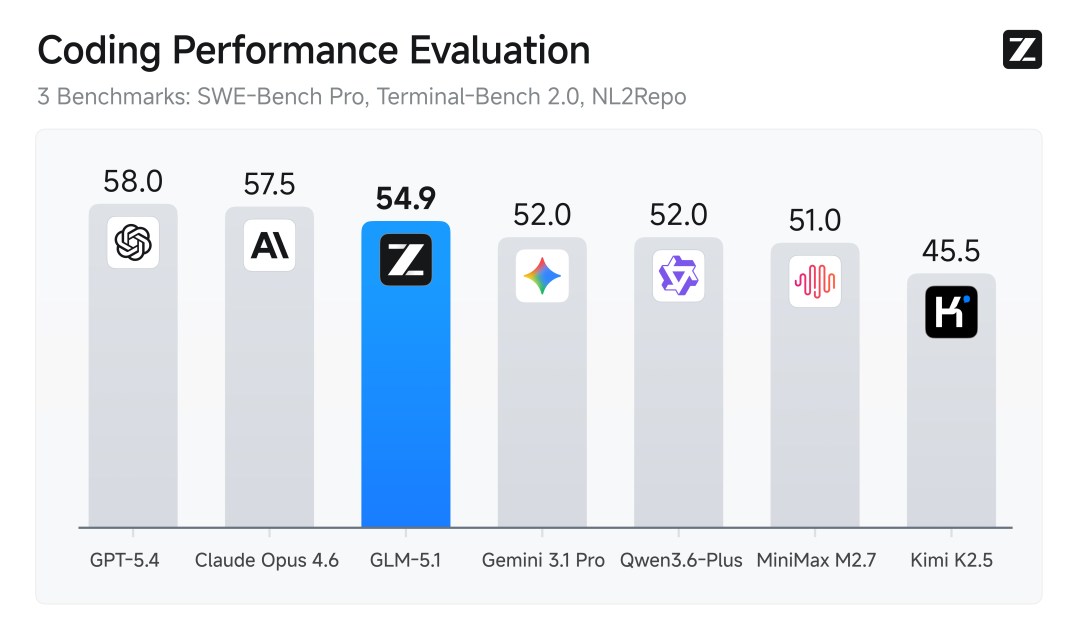
代码能力是模型智能水平进一步提升的关键。下图是业内最具源大代表性的三个代码评测基准的平均结果,包括衡量模型专业软件开发工作的 SWE-Bench Pro、操作命令行解决问题的 Ter模型minal-Bench 2.0、从零构建完整代码仓库的 NL2Repo,GLM-5.1 取得全球模型第三、国产模型第一 S、开源模型第一。

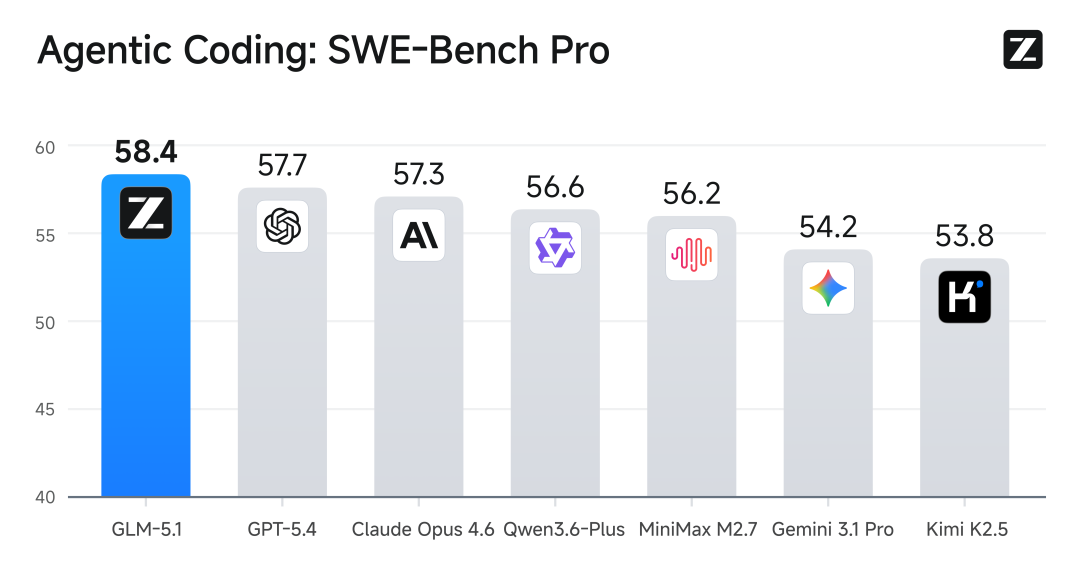
在最接近真实软件开发的 SWE-bench Pro 基准测试中,GLM-5.1 刷新全球最佳成绩,超过 GPTWE-5.4、Claude Opus 4.6。SWE-Bench Pro 要求模型在真实 GitHub 仓库中定位并修复高难度工程 Bug-b,是衡量模型能否胜任专业软件开发的最硬指标。